Rekrutacja
Największy błąd kandydatów na rekrutacji programisty? Ich Git i GitHub
Na dwóch publicznych repozytoriach pokazuję, co rekruter widzi w README, pull requestach i commitach.
 film wkrótce na YouTube
Rekrutowałem programistów i szczerze mówiąc, kandydaci najczęściej odpadali na jednej rzeczy - nie na trudnym pytaniu technicznym, tylko na tym, jak wyglądał ich Git i GitHub. Wydaje mi się, że to bardzo niedoceniana sprawa, więc postanowiłem pokazać ją na żywych przykładach: dwóch publicznych repozytoriach, które akurat miałem pod ręką. Jedno jest dobre, drugie słabe.
„Znam Gita” w CV to czerwona flaga
Zacznę od błędu, który widzę regularnie. Część kandydatów w krótkim opisie na górze CV - tych pięciu, ośmiu zdaniach, które mają definiować, kim są - wypisuje obok znajomości języków programowania także „znajomość Gita”. I za każdym razem myślę: o co tu w ogóle chodzi?
Wyobraźcie sobie, że idziecie rekrutować się na budowę i mówicie majstrowi: „proszę pana, ja świetnie umiem obsługiwać wkrętarkę”. Spojrzy na was jak na wariata - wkrętarkę umie obsługiwać każdy, kto się tam zatrudnia, to żadne osiągnięcie. Z Gitem jest dokładnie tak samo. To podstawowe narzędzie pracy programisty, więc wypisywanie w CV, że się go „umie”, świadczy tylko o tym, że mam do czynienia z kimś totalnie początkującym.
Czy w ogóle można o Gicie wspomnieć? Jasne - w CV jest zwykle sekcja z listą technologii i tam Git może się znaleźć obok reszty stacku. Tam jest jego miejsce, nie w kluczowych zdaniach na górze.
To, co jest naprawdę niedoceniane, to fakt, że samym Gitem i sposobem prowadzenia projektu można w oczach rekrutera bardzo dużo zyskać albo bardzo dużo stracić. Pokażę to na dwóch repozytoriach.
Dobry przykład: repozytorium kolegi
Pierwszy przykład to repozytorium kolegi, z którym kiedyś pracowałem - bardzo dobrego programisty. Nie konsultowałem z nim tego filmu, po prostu poszperałem, czy ma coś do pokazania, i trafiłem na projekt multi-step-form. Nie wiem, czy to było zadanie rekrutacyjne, ale jako przykład dobrze poprowadzonego repozytorium sprawdza się świetnie.
README
Gdyby to było prawdziwe zadanie rekrutacyjne, pierwsze, na co patrzę jako rekruter, to README.
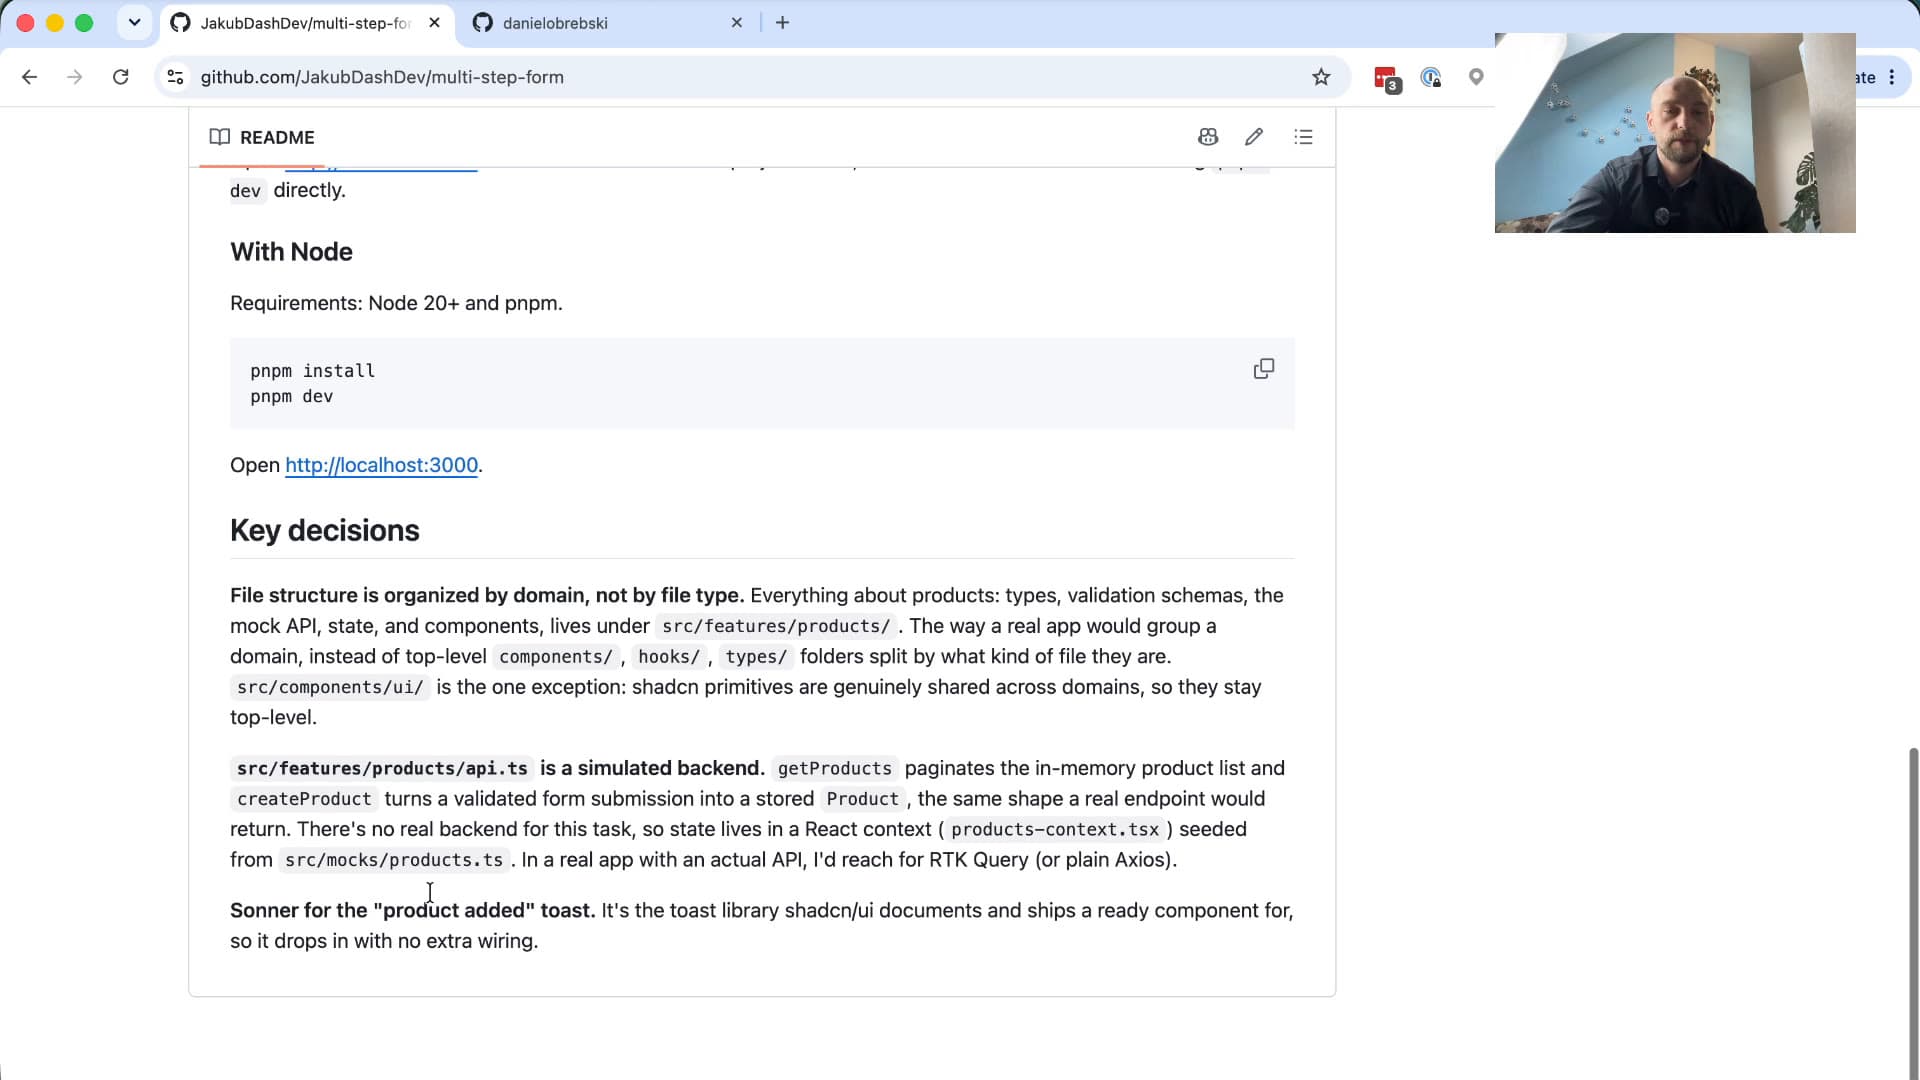
Jest ładnie opisane, po angielsku, z instrukcją, jak projekt odpalić (na Dockerze albo bez), oraz z sekcją Key decisions, w której autor krótko tłumaczy swoje wybory architektoniczne, np.:
File structure is organized by domain, not by file type. Everything about products: types, validation schemas, the mock API, state, and components, lives under
src/features/products/. (...)src/components/ui/is the one exception: shadcn primitives are genuinely shared across domains, so they stay top-level.
To bardzo fajne, bo od razu wiem, co autor zrobił i dlaczego, bez czytania całego kodu. Jest też link do działającej wersji aplikacji - spory plus, jeśli ktoś kandyduje o pracę. Taki link zawsze warto od razu sprawdzić, bo kandydaci często podają linki, które po prostu nie działają. Tutaj działa i to nawet nieźle wygląda. Rewelacja.
Dlaczego pull requesty są takie ważne
Teraz to, o czym właściwie jest cały film, czyli Git i GitHub. Jeśli dostaję repozytorium do przejrzenia, pierwsze, co sprawdzam, to czy kandydat w ogóle korzysta z pull requestów.
Nie klikam po aplikacji, żeby zobaczyć, jak wygląda UI - tak się tego nie robi. Chcę zobaczyć, jak ktoś faktycznie zakodował dany kawałek projektu, więc wchodzę w pull requesty. Sporo początkujących programistów w ogóle z nich nie korzysta, więc jeśli ktoś to robi, to już jest dobry znak.
Dlaczego to takie istotne? Bo tak pracuje się w zespole. Jeśli szukam kogoś do zespołu, a kandydat nigdy nie robił pull requestów, to wiem, że taką osobę trzeba będzie przez 2-3 dni wdrażać w to, jak w ogóle pracuje się w grupie.
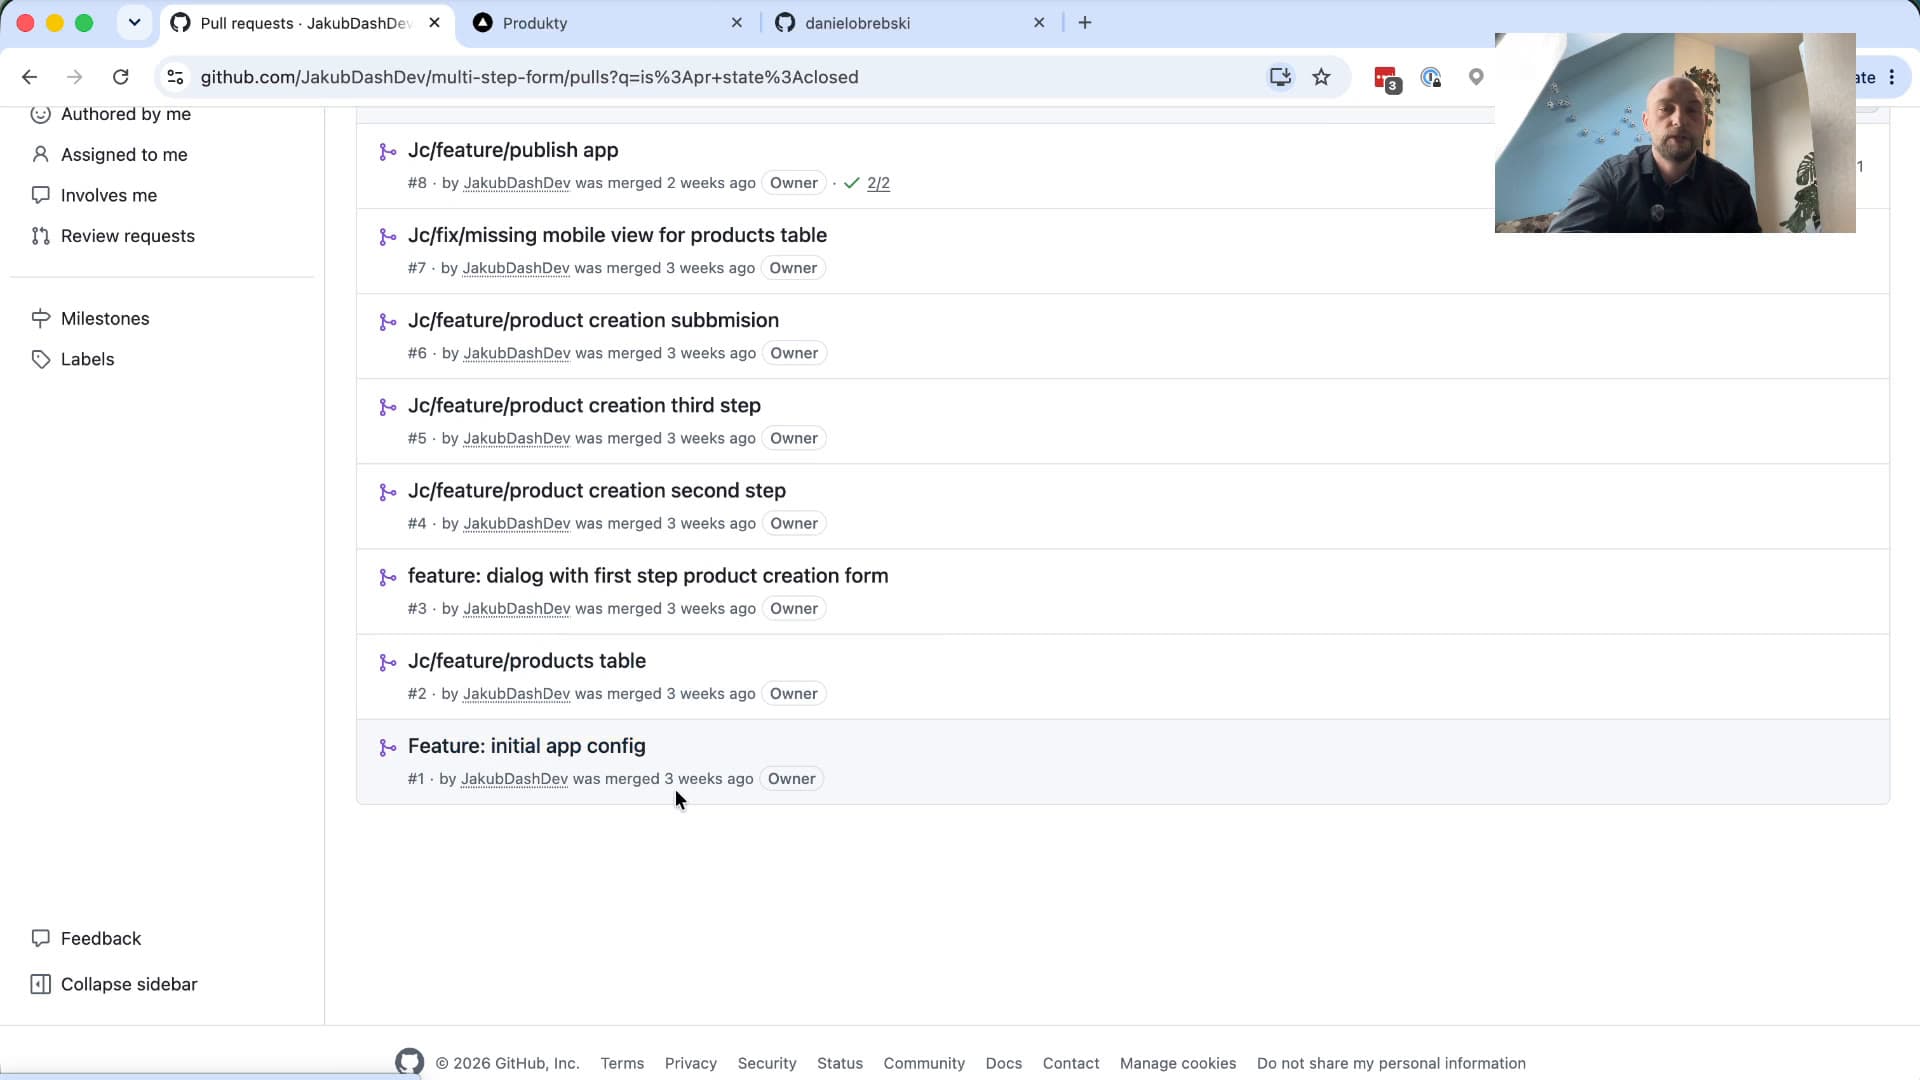
Kuba (autor repozytorium) robi pull requesty, więc wchodzę w nie i patrzę. Pierwszy to Feature: initial app config - i to jest rewelka, bo nawet nie muszę do niego zaglądać, już wiem, co się stało: to standardowy scaffold create-next-app, nie jego kod. Nie muszę tego recenzować.
Drugi, ciekawszy, to Jc/feature/products table - 16 zmienionych plików. Mogę je spokojnie przejrzeć i ocenić, czy tabelka produktów została dodana tak, jak bym tego oczekiwał. Mam dokładnie wyznaczony zakres: 16 plików, jedno konkretne zagadnienie, łatwo to ogarnąć.
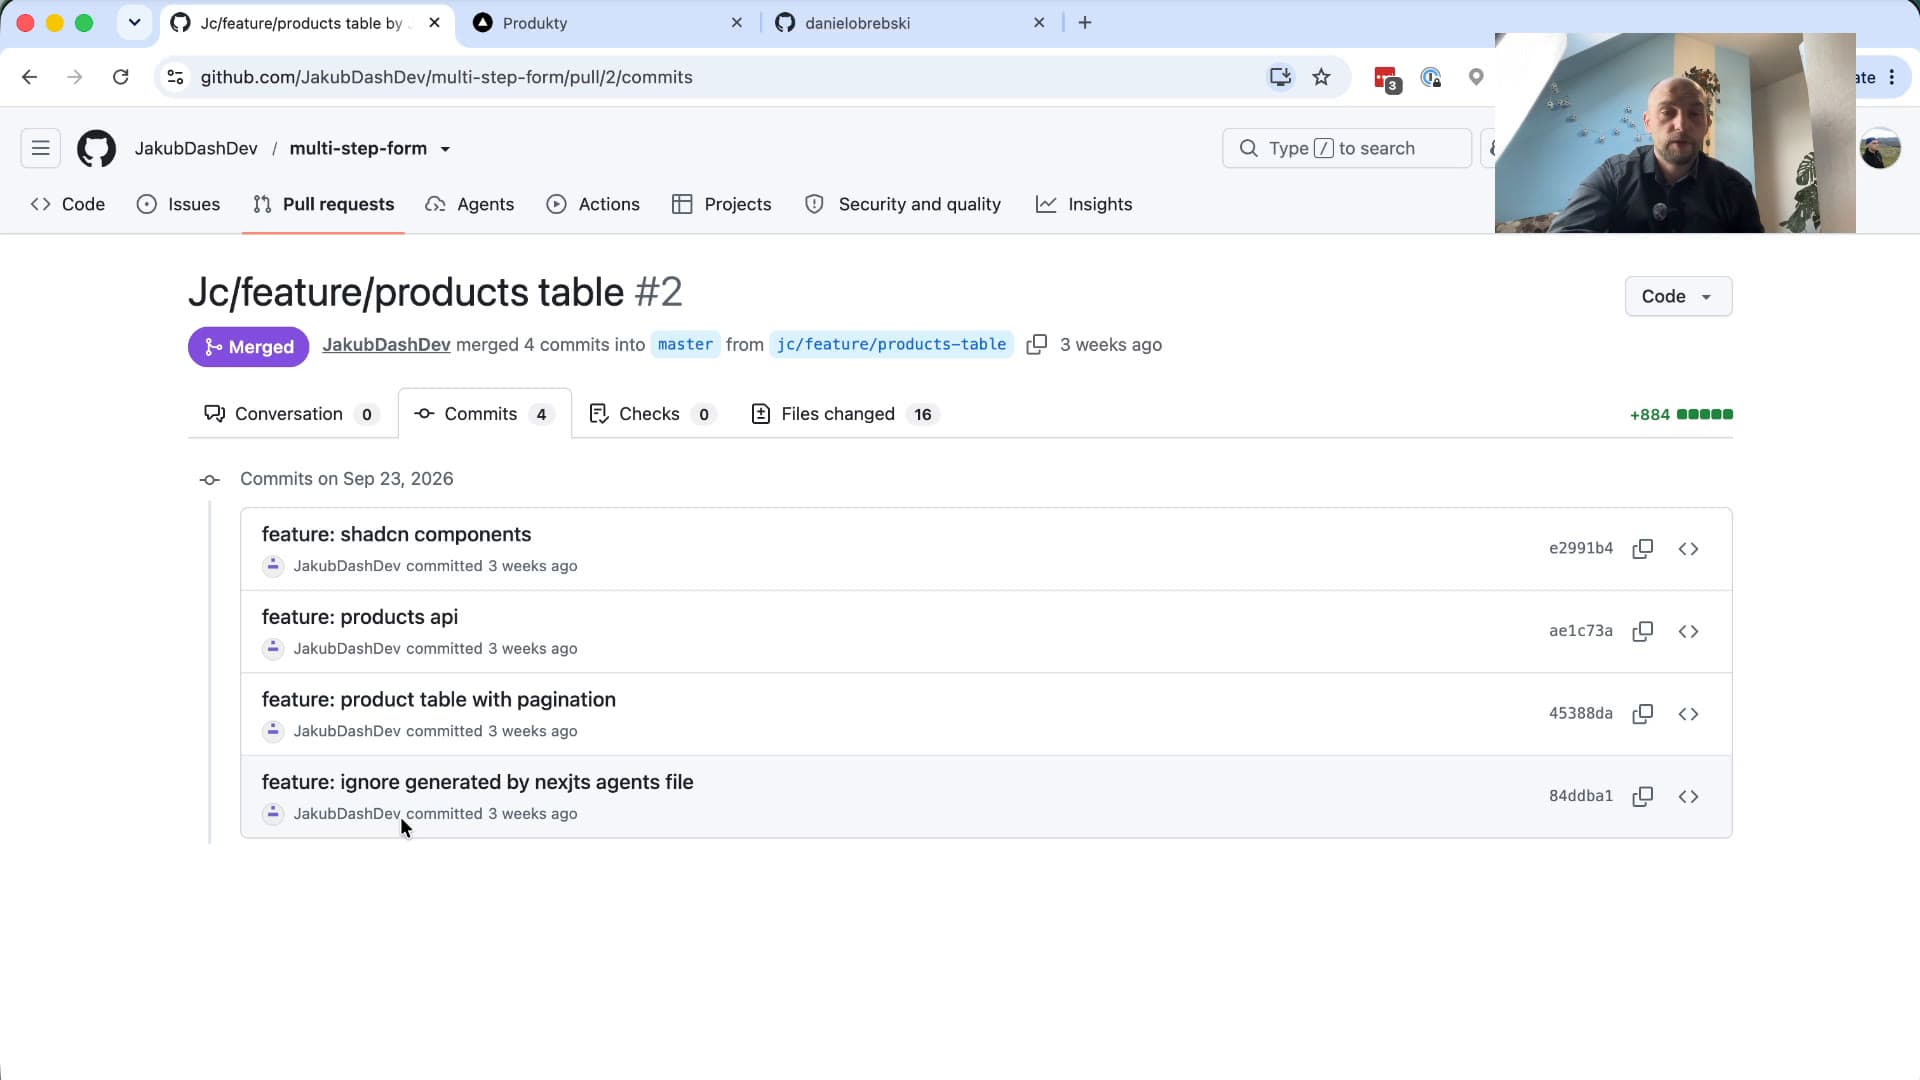
W tym pull requeście są cztery osobne commity: feature: shadcn components, feature: products api, feature: product table with pagination i feature: ignore generated by nexjts agents file. Sam tytuł ostatniego mówi mi, co się w nim dzieje - nie muszę otwierać diffa, żeby wiedzieć, że to tylko wpis do .gitignore.
Jak dobrze opisywać commity
To prowadzi do konwencji opisywania commitów. Moim zdaniem w commicie nie opisujemy tego, co zrobiliśmy, bo to zawsze można podejrzeć w diffie. Opisujemy raczej, po co to zrobiliśmy.
Weźmy commit o ignorowaniu wygenerowanego pliku. Zamiast tytułu, który powtarza to, co widać w zmianach, można by napisać coś w stylu don't need to track agents file - czyli uzasadnienie, a nie opis zmiany. Oczywiście przy bardzo trywialnych rzeczach commit mówiący wprost, co jest w środku, też jest w porządku - nie trzeba z tego robić dogmatu. Ale najlepszy commit tłumaczy, dlaczego coś powstało, bo to, co powstało, i tak widać w zmianach.
Jedyne, czego mi tu brakuje, to opisy samych pull requestów. Przy repozytorium, które wygląda tak dobrze, krótki opis PR-a to drobiazg, a dodatkowo świadczy o sumienności kandydata. To naprawdę nic trudnego, a daje spory plus na starcie rekrutacji.
Zły przykład: zadanie rekrutacyjne w Javie
Dla kontrastu poszukałem w internecie pierwszego lepszego zadania rekrutacyjnego i trafiłem na zadanie rekrutacyjne w Javie niejakiego Daniela. Nie znam tej osoby - to repozytorium posłużyło mi po prostu jako przykład tego, jak nie robić tego samego.
Po pierwsze, jest README, co jest na plus - czasem nie ma go wcale. Ale jest opisane dość ubogo i po polsku, co w międzynarodowym środowisku pracy jest raczej minusem (10 lat temu może by uszło, dziś już niekoniecznie). Ogólnie README wypada na minus.
Brak pull requestów
Sprawdzam dalej - pull requesty. I… nie ma żadnych. Kandydat w ogóle z nich nie korzysta, nawet w zadaniu rekrutacyjnym, gdzie akurat miał okazję to pokazać. To bardzo duży minus. Jako rekruter (a jestem, jak sam siebie żartobliwie nazywam, „stary grzyb”) od razu widzę sygnał, że kandydat jest najprawdopodobniej niedoświadczony.
Chaotyczna historia commitów
Skoro nie ma pull requestów, wracam do samych commitów.
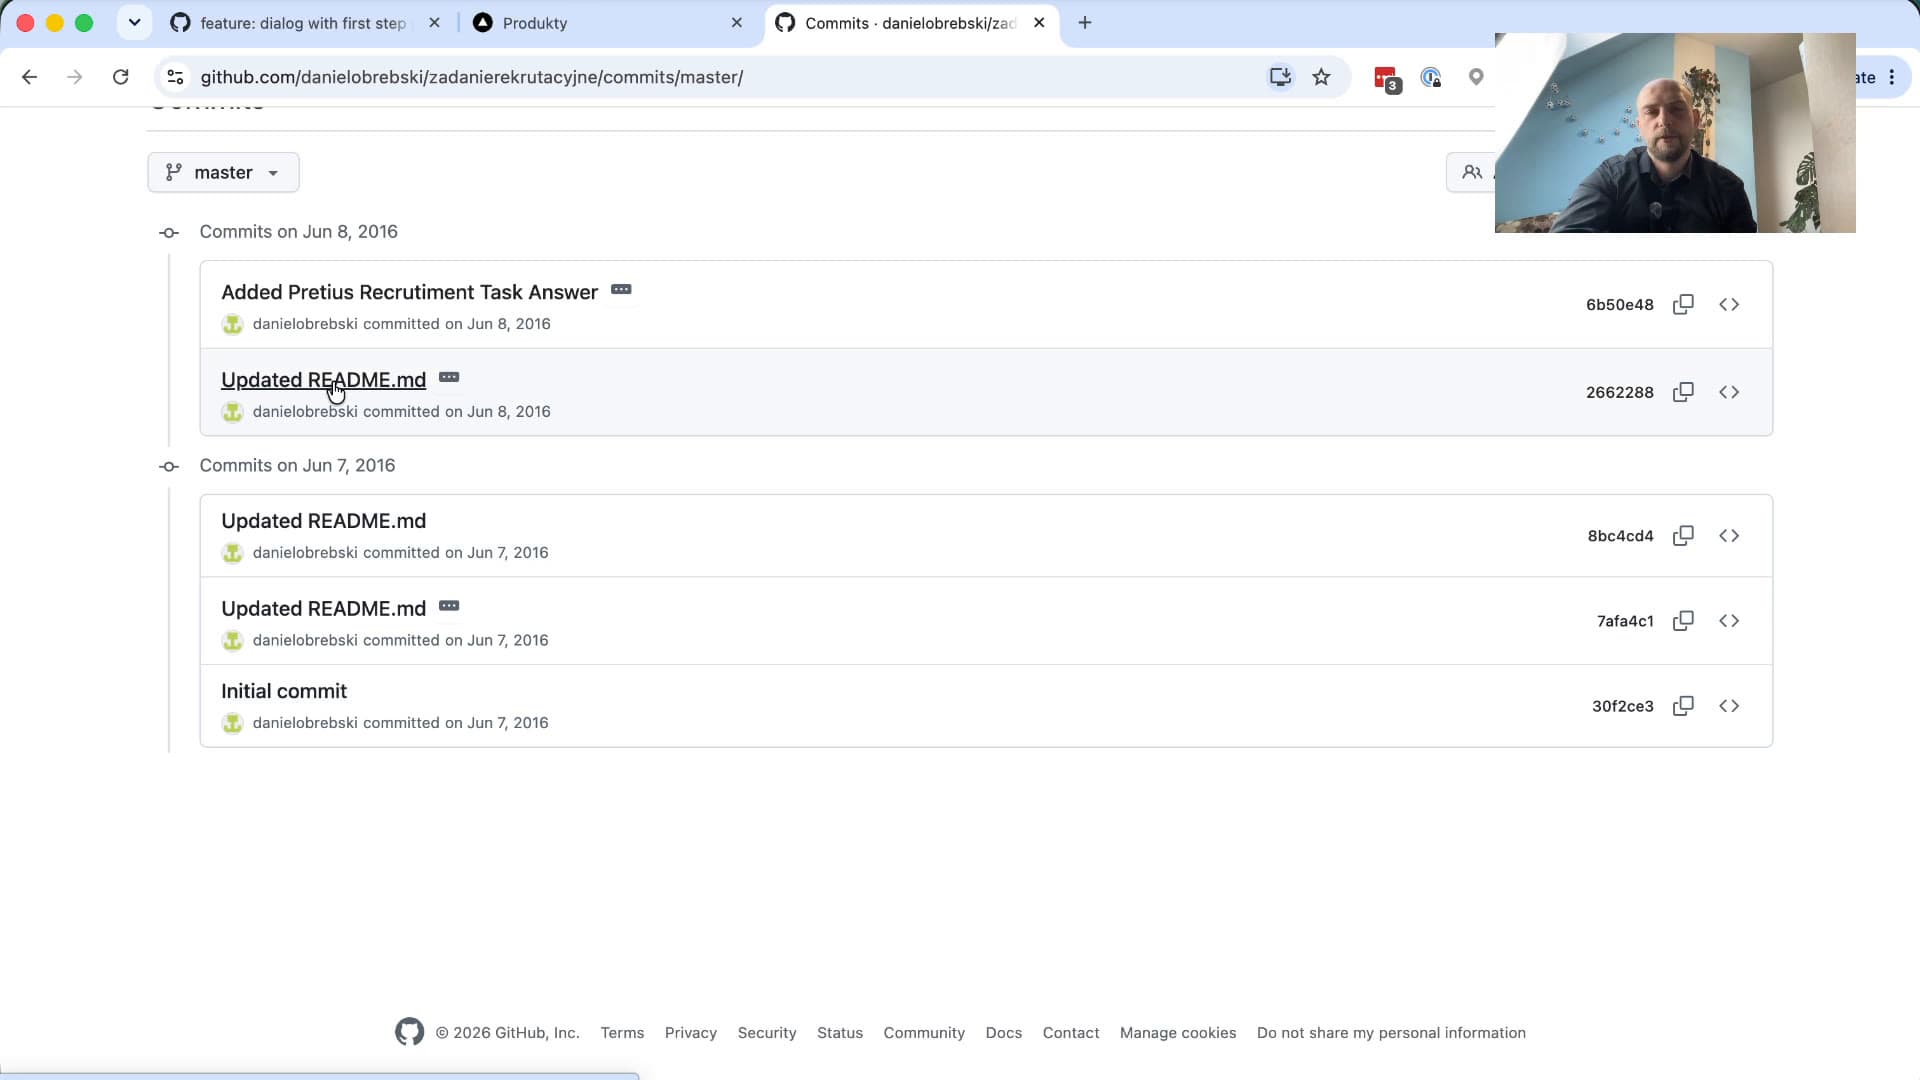
Commitów jest tylko pięć, ale od razu widać brak ładu: Initial commit, potem kilka razy z rzędu Updated README.md, aż w końcu właściwy Added Pretius Recrutiment Task Answer. Czasem widuje się repozytoria z kilkunastoma commitami w stylu „fix coś tam, fix coś tam”, bez żadnego ładu i składu. Tutaj jest podobnie - po całości widać, że kandydat jest niedoświadczony. W pierwszym repozytorium od razu widać doświadczenie, i to komercyjne.
Podsumowanie
Takimi prostymi krokami - dobrym README, pull requestami i sensownie opisanymi commitami - można już na etapie rekrutacji mocno poprawić pierwsze wrażenie. I to działa, bo zdecydowana większość kandydatów tego nie robi: albo w ogóle nie dokumentuje swojej pracy w ten sposób, albo robi to bardzo słabo.
Jeśli mam trzydziestu kandydatów i tylko kilku prowadzi repozytoria porządnie, to oni od razu przyciągają moją uwagę - łatwiej mi zrecenzować ich pracę i o wiele chętniej z taką osobą porozmawiam.
Zadbajcie też o repozytoria, które macie publicznie - rekruterzy na pewno na nie patrzą. Dobrze mieć tam projekty, którymi faktycznie chcecie się pochwalić. Jeśli coś jest niedopracowane, lepiej ustawić je jako prywatne, niż zostawiać na widoku.