Podstawy
Jak assembler zamienia się w kod maszynowy? ARM64 ręcznie z dokumentacji
Instrukcja add w1, w1, #1 zakodowana ręcznie z dokumentacji ARM64, bit po bicie. Potem to samo w Dockerze: as, objdump, gcc i program, który zwraca 5.
Skąd wychodzimy
Ostatnio wcieliłem się w procesor w Excelu. Napisałem tam prosty pseudoassembler i przechodziłem przez niego linijka po linijce, wpisując wartości do komórek. Każda z moich instrukcji przekłada się 1 do 1 na prawdziwy assembler ARM64:
.global main
main:
    mov  w1, #0          // set_value 0, licznik
loop:                    // poczatek_petli:
    add  w1, w1, #1      // add licznik = licznik + 1
    cmp  w1, #5          // compare licznik, 5
    b.mi loop            // if oznaczenie == minus -> goto poczatek_petli
    mov  w0, w1          // return licznik
    ret
Po co wymyślałem własne nazwy? Bo prawdziwe są dla mnie mało przyjemne. mov w1, #0 jest po prostu mniej ludzkie niż set_value 0, licznik.
Każda architektura ma swój assembler
ARM64 to tylko jeden z wielu assemblerów. Każda architektura procesora ma swój własny, ale tych architektur wcale nie ma tak dużo, powiedzmy kilka podstawowych. I co ciekawe, wszystkie wyglądają bardzo podobnie. Ten sam licznik na kilku z nich:
| ARM64 (Mac M1+, telefony) | x86-64 (Intel, AMD) | RISC-V |
|---|---|---|
mov w1, #0 | mov ecx, 0 | li a1, 0 |
add w1, w1, #1 | add ecx, 1 | addi a1, a1, 1 |
cmp w1, #5 | cmp ecx, 5 | - |
b.mi loop | js loop | blt a1, t0, loop |
RISC-V nie ma flag, więc porównanie robi w samej instrukcji skoku. Swój assembler ma też AVR, czyli procesor z Arduino Uno. Jeśli napiszesz coś w jednym, w miarę spokojnie przepiszesz to na inny.
Zanim był assembler
Procesory rozumieją tylko liczby. Jak to się stało, że możemy wpisywać słowa, a procesor jakoś je rozumie? Krótka historia:
- Z3 - bity czytane po kolei (w to się nie zagłębiałem),
- 1944 - instrukcje na taśmie papierowej,
- 1945 - przełączniki. Przestawienie ich wszystkich trochę trwało, ale tak wtedy pisało się programy,
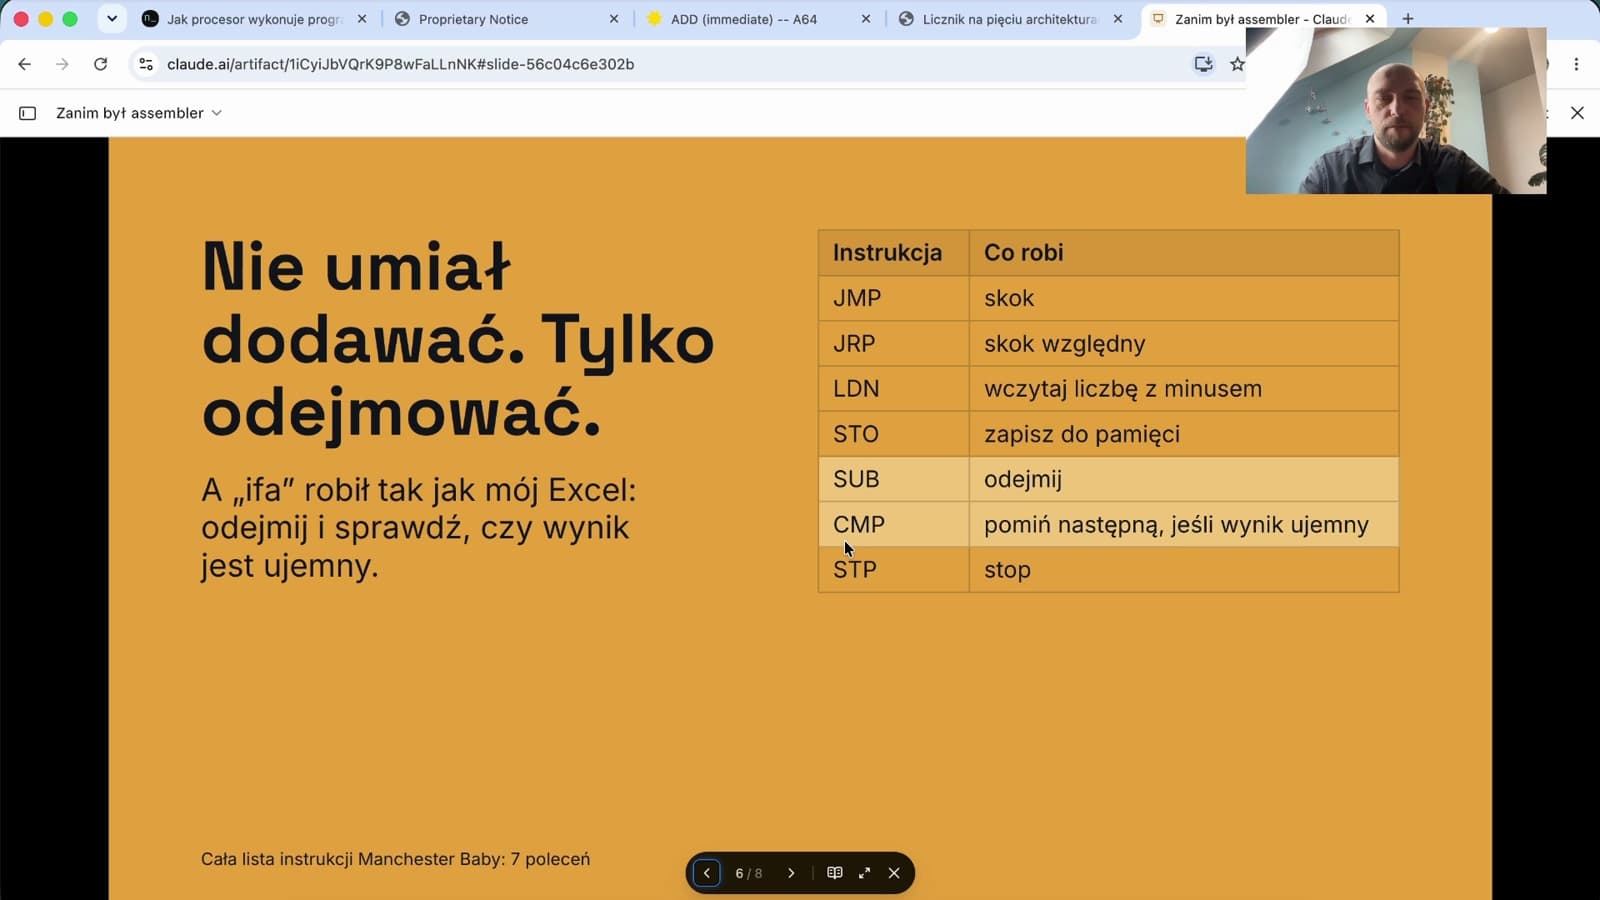
- 1948, Manchester Baby - tu są już konkretne polecenia, każde z przypisaną liczbą. Nie dało się ich jeszcze wpisać słowami, ale program z samych liczb już działał,
- 1949 - maszyna potrafiła zinterpretować literkę (np. „A”, oczywiście wybitą na dziurkach) jako odpowiednią instrukcję. To jest już bardzo podobne do tego, co mamy dziś.
3289 stron dokumentacji ARM64
Każdy procesor ma swój zbiór instrukcji i opis tego, jak dokładnie trzeba je do niego przekazać. Działa to trochę inaczej, niż się wydaje: istnieje oficjalny, ogólny zbiór instrukcji, np. dla ARM64, a producent procesora się do niego dostosowuje.
Dokumentacja zbioru instrukcji A64 ma 3289 stron. Masakra. Dlatego nikt nie wpisuje procesorowi liczb ręcznie, tylko pisze w assemblerze.
Ale co, gdyby się uprzeć?
Koduję add w1, w1, #1 bit po bicie
Biorę jedną instrukcję z mojego licznika, add w1, w1, #1, i szukam jej w dokumentacji: ADD (immediate). Ta strona mówi, jakie bity i gdzie trzeba wpisać, żeby procesor zrozumiał „dodaj stałą do rejestru”. Na pierwszy rzut oka jest totalnie hardkorowa, ale tak naprawdę nie jest to skomplikowane.
(Wiem, że to nie jest „funkcja”, tylko instrukcja. Wszystkich, których to wkurza, przepraszam, trzeba to jakoś zaakceptować.)
Procesor musi dostać dokładnie 32 bity. Wypełniam je od lewej:
| Pole | Bity | Co znaczy | Wartość |
|---|---|---|---|
sf | 1 | rozmiar rejestru: 0 = w (32 bity), 1 = x (64 bity) | 0 |
op | 1 | 0 = dodawanie, 1 = odejmowanie | 0 |
S | 1 | czy ustawić flagi NZCV (dla ADD: nie) | 0 |
| stałe | 6 | „to jest dodawanie/odejmowanie stałej”, przepisuję bez zmian | 100010 |
sh | 1 | 1 = przesuń stałą (gdybym chciał dodać dużą liczbę) | 0 |
imm12 | 12 | liczba do dodania | 000000000001 |
Rn | 5 | z którego rejestru brać wartość: w1 | 00001 |
Rd | 5 | do którego rejestru zapisać wynik: w1 | 00001 |
Stałe bity to jedyna rzecz, która odróżnia tę instrukcję od innych. Inna instrukcja ma w tym miejscu po prostu inny zestaw bitów.
Po złożeniu:
0 0 0 100010 0 000000000001 00001 00001
= 0001 0001 0000 0000 0000 0100 0010 0001
= 0x11000421
Gdy procesor dostanie dokładnie te 32 bity, wie, że ma w środku wykonać dodawanie. Do zabawy przygotowałem kalkulator, w którym można to przeklikać samemu:
Cały program w kodzie maszynowym
W ten sam sposób można rozpisać każdą instrukcję. Nie będę tu rozpisywał każdej po kolei, bo trochę mija się to z celem. Cały program przepisany w ten sposób wygląda tak (sprawdziłem, zgadza się z tym, co wypluwa prawdziwy assembler):
| Adres | Instrukcja | Kod maszynowy |
|---|---|---|
| 0 | mov w1, #0 | 0x52800001 |
| 4 | add w1, w1, #1 | 0x11000421 |
| 8 | cmp w1, #5 | 0x7100143F |
| 12 | b.mi loop | 0x54FFFFC4 |
| 16 | mov w0, w1 | 0x2A0103E0 |
| 20 | ret | 0xD65F03C0 |
Gdyby te liczby jakoś magicznie wrzucić do procesora, program powinien się wykonać.
Assembler zrobi to za nas
Ręczne przepisywanie bitów da się zautomatyzować. Może nie łatwo, ale da się to zrobić właściwie w dowolnym języku: program, który zamienia instrukcje assemblera na odpowiednie bity. Tym właśnie jest assembler. Nie muszę go pisać, bo gotowy siedzi w GCC (GNU Compiler Collection). Ten zestaw zawiera mnóstwo kompilatorów, w tym ten dla ARM64.
Jak zwykle wszystko odpalam w Dockerze. Mam jeden główny projekt z docker-compose.yml, a każdy eksperyment to osobny serwis:
services:
  arm_assembler_simple_counter:
    image: gcc:latest #GNU Compiler Collection
    platform: linux/arm64
    container_name: arm_assembler_simple_counter
    volumes:
      - ./arm_assembler_simple_counter:/build
    working_dir: /build
    command: tail -f /dev/null
image: gcc:latest- obraz z całym GCC,platform: linux/arm64- mój program jest napisany w ARM64, więc kontener też musi być ARM64,container_name- opcjonalne, ale lubię to dodawać,volumes- żeby kontener widział w/buildmoje pliki,command: tail -f /dev/null- komenda, która nic nie robi, ale dzięki niej kontener cały czas działa.
Asemblacja, objdump i uruchomienie
Stawiam kontener i wchodzę do środka:
docker compose up -d
docker exec -it arm_assembler_simple_counter bash
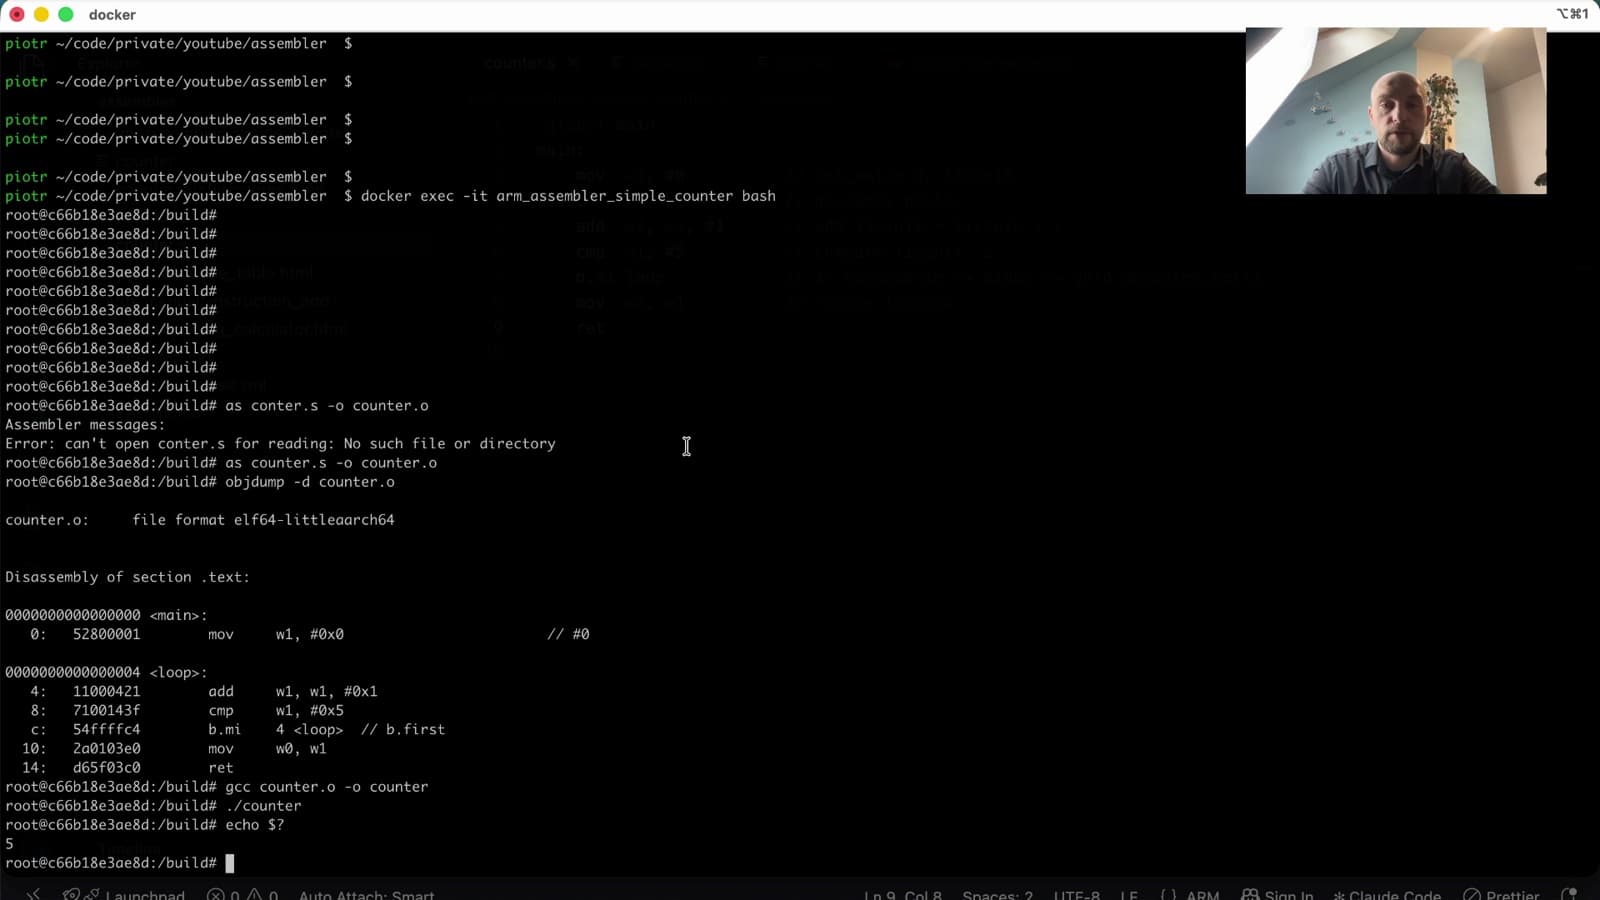
Zamieniam assembler na kod maszynowy (-o to plik wyjściowy):
as counter.s -o counter.oI zaglądam do środka:
objdump -d counter.o0000000000000000 <main>:
0: 52800001 mov w1, #0x0
0000000000000004 <loop>:
4: 11000421 add w1, w1, #0x1
8: 7100143f cmp w1, #0x5
c: 54ffffc4 b.mi 4 <loop>
10: 2a0103e0 mov w0, w1
14: d65f03c0 retCały mój assembler zmapował się na konkretny kod maszynowy, dokładnie ten sam, który wcześniej wyliczyłem ręcznie. 11000421 to moje add w1, w1, #1.
Po lewej są adresy w pamięci, ale względne. Program po uruchomieniu nie trafi pod adres 0 ani 4, tylko tam, gdzie przydzieli mu system, a wszystkie adresy będą liczone względem tego początku. Żeby to ogarnąć i zrobić z tego normalny plik wykonywalny, używam gcc:
gcc counter.o -o counterPowstaje zwykła binarka. Po otwarciu w edytorze to tylko szlaczki, ale da się ją uruchomić. Według programu na końcu powinna zwrócić ostatnią wartość licznika, czyli 5:
./counter
echo $?
Sam program nic nie wypisuje, więc echo $? pokazuje kod, z którym zakończył działanie. Wynik: 5, dokładnie tak, jak przewidywałem.
Podsumowanie
Przeszedłem drogę od pseudoprogramu napisanego w Google Docs, przez Excela, ręczne kodowanie bitów z dokumentacji, aż do prawdziwego assemblera w Dockerze, który zamienił mój kod na kod maszynowy i uruchomił go na komputerze. Myślę, że to w miarę kompletna całość.
Dalej będę pewnie robił podobne rzeczy, ale już w oparciu o D1 mini.
Cały kod z odcinka, razem z kalkulatorem, jest w repozytorium youtube-low-level na GitHubie.